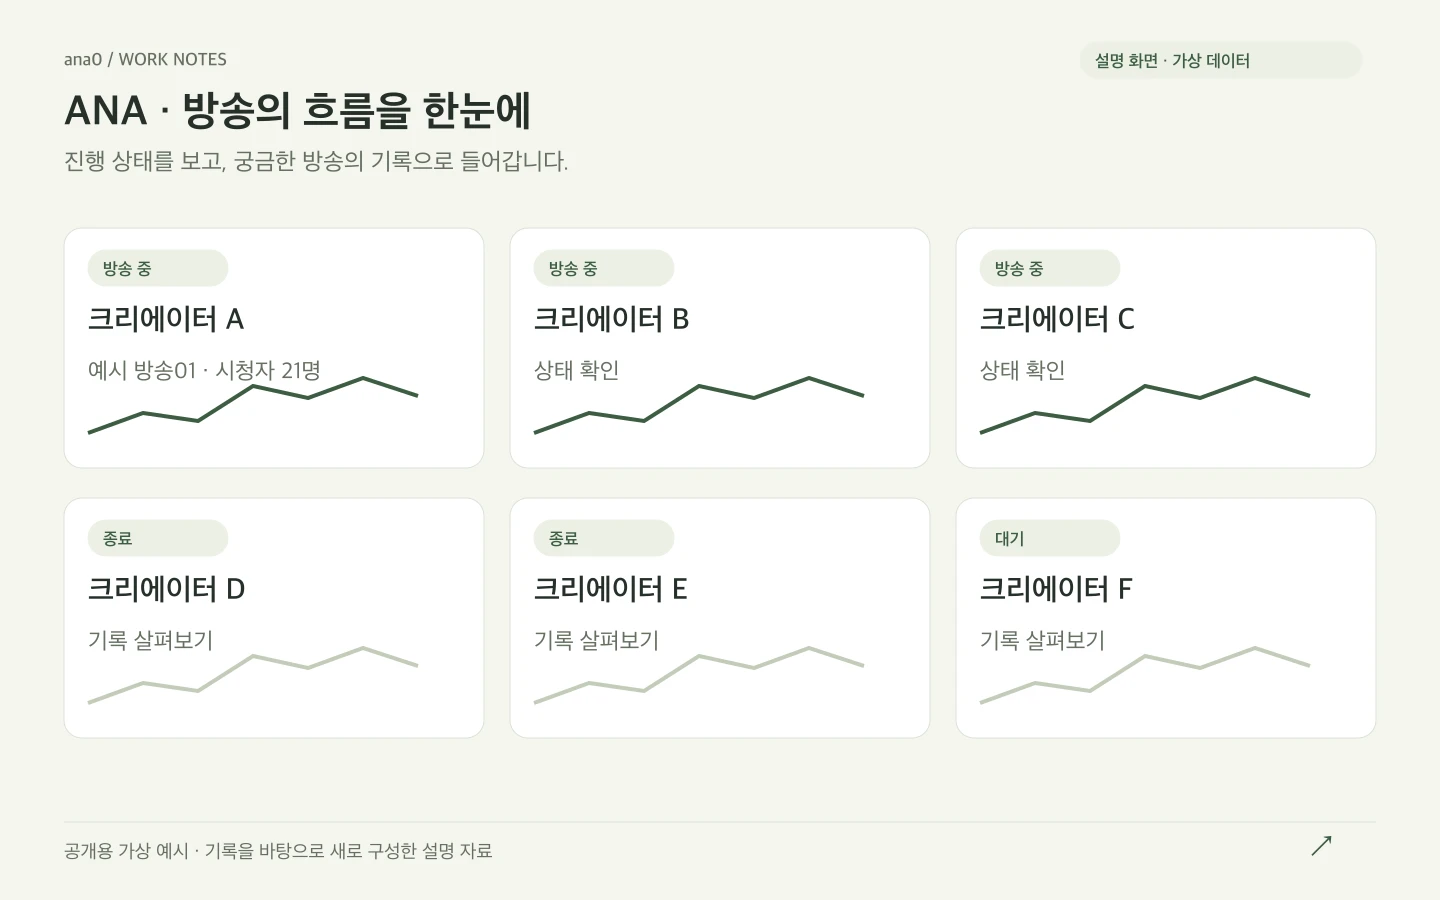
왜 만들었나
방송에서는 시청자 수가 바뀌고, 댓글이 이어지고, 발화가 지나갑니다. 결과를 살펴보려면 숫자와 그때의 맥락을 함께 확인할 자료가 필요했습니다.
ANA는 그 흐름을 세션별로 수집하고 분석할 수 있도록 만든 도구입니다. 센스나인에서 Python 수집·분석 엔진을 직접 구현하고 운영했으며, AI를 개발과 분석에 활용했습니다. 이 페이지는 당시 작업을 돌아보는 기록입니다.
쓰는 순간 — 방송의 시간을 따라 보기
먼저 여러 방송의 진행 상태를 살펴보고, 궁금한 방송의 상세 기록으로 들어갑니다. 시청자 변화와 발화가 같은 시간대에 놓이면 무엇을 더 확인해야 할지 찾기 쉬워집니다. 함께 일어난 두 현상만으로 원인과 결과를 단정하지는 않습니다.
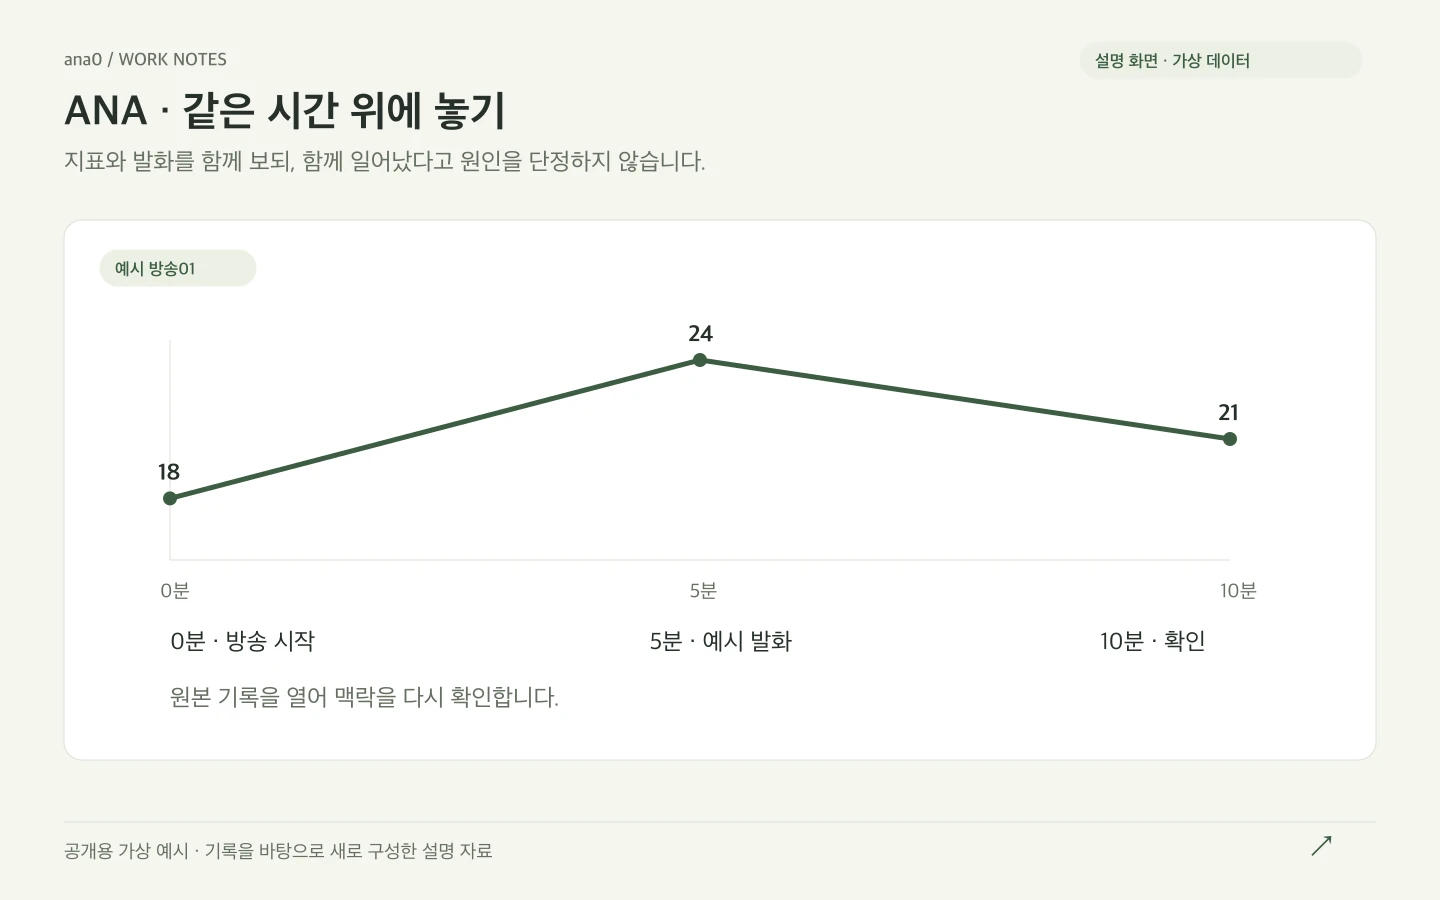
가상 시계열을 같은 시간축에 놓은 설명 화면입니다. 실제 방송 결과가 아닙니다.
숫자를 계산하는 일과 설명하는 일
숫자 계산과 규칙 처리를 맡는 부분, AI가 문장을 만드는 부분을 구분했습니다. 요약만 읽고 끝내지 않고, 어떤 원본 기록에서 나온 이야기인지 돌아볼 수 있어야 했습니다.
당시 작업과 설계 기록을 정리한 설명도입니다.
원본을 남겨두는 이유
수집한 텍스트가 모두 정확한 발화는 아니었습니다. 배경음악을 음성 인식기가 반복 문장으로 바꾸는 문제가 있었고, 여러 세션에 공통으로 등장하는 구절을 분석 단계에서 걸러내는 코드를 만들었습니다. 필터의 판단이 틀릴 가능성도 있어 원본은 삭제하지 않았습니다.
원본과 분석본을 분리하는 방향을 설명합니다. 자체 학습 모델 출시를 뜻하지 않습니다.
쓰면서 남은 질문
기록이 쌓이면서 보관 방식도 다시 검토했습니다. 파일과 동기화 폴더는 시작하기 쉬웠지만, 여러 프로세스가 쓰고 필요한 데이터를 찾는 데 한계가 있었습니다. DB와 조회 구조를 바꾸는 방안을 정리했으며, 그 제안을 모두 운영에 적용한 것으로 소개하지 않습니다.
수집·분석 엔진은 직접 설계·구현·운영한 작업입니다. AI는 개발과 분석을 보조했습니다. 브라우저 보조도구와 알림 봇까지 개인 단독 기여로 확대하지 않습니다.